Le schede grafiche consumer di NVIDIA potrebbero nascondere un potenziale di calcolo superiore a quello disponibile con le configurazioni standard. Due progetti di modifica, sviluppati per le GPU GeForce RTX 30 e RTX 40, hanno dimostrato la possibilità di aumentare sensibilmente le prestazioni nei calcoli legati all’intelligenza artificiale, arrivando in alcuni casi a raddoppiare la velocità di elaborazione.
Gli interventi riguardano le architetture Ampere e Ada Lovelace e puntano a sbloccare funzionalità di calcolo che, secondo i risultati riportati, risultano limitate dalla configurazione software e firmware delle schede GeForce. I benefici interessano soprattutto le operazioni matematiche utilizzate nelle reti neurali e nell’esecuzione locale dei modelli linguistici di grandi dimensioni, conosciuti come LLM.
Le modifiche funzionerebbero con i driver NVIDIA standard e senza aumentare il consumo energetico nominale della scheda. È però importante sottolineare che si tratta di interventi non ufficiali, che comportano rischi tecnici e possono invalidare la garanzia del prodotto.
NVIDIA RTX 30: fino all’80% di prestazioni in più con la RTX 3090 Ti
Il primo progetto interessa le schede video GeForce RTX 30 basate sull’architettura Ampere, introdotta da NVIDIA nel 2020. Secondo quanto riportato, un ricercatore è riuscito a intervenire sul comportamento delle GPU per aumentare la velocità di emissione delle istruzioni relative alle operazioni FMA, ovvero Fused Multiply-Add, utilizzate nei calcoli matematici intensivi.
La modifica interessa le operazioni FP32 e BF16, due formati numerici utilizzati in ambito computazionale e nell’intelligenza artificiale. In particolare, il BF16, o Brain Floating Point 16, consente di eseguire calcoli con numeri a 16 bit, offrendo un compromesso tra precisione numerica, utilizzo della memoria e velocità di elaborazione.
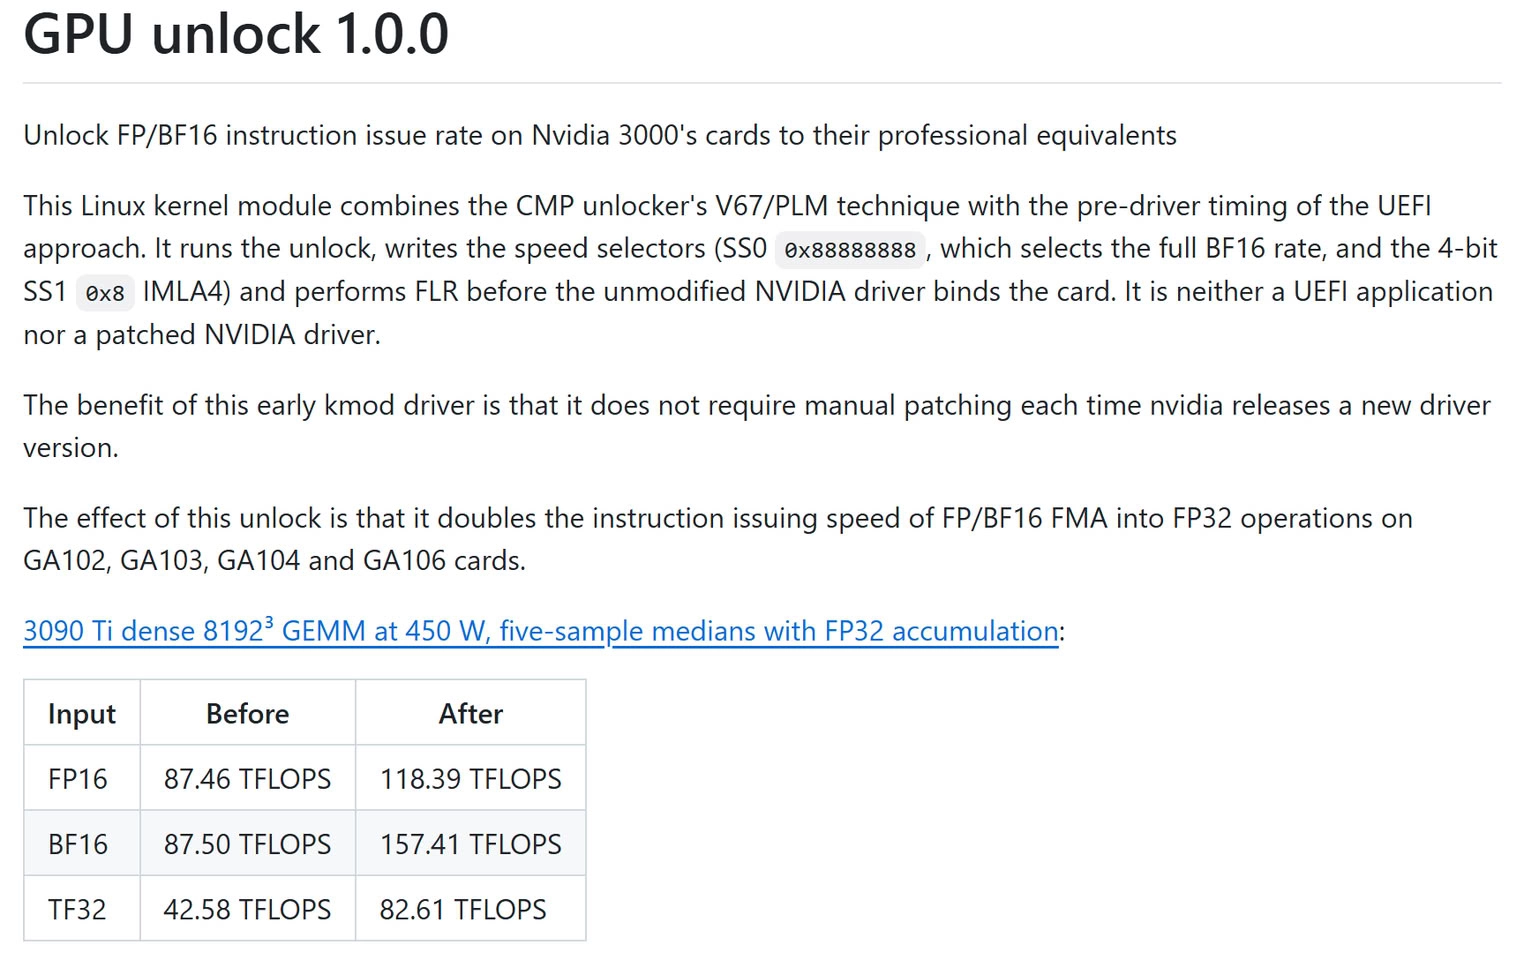
L’intervento riguarda le GPU con chip GA102, GA103, GA104 e GA106, presenti in diversi modelli della famiglia GeForce RTX 30. I risultati segnalati sono particolarmente interessanti per la NVIDIA GeForce RTX 3090 Ti, sulla quale la modifica avrebbe consentito di ottenere un incremento fino all’80% nelle prestazioni di moltiplicazione di matrici in BF16.
Si tratta di un miglioramento significativo per chi utilizza la scheda video non soltanto per giocare, ma anche per eseguire modelli di intelligenza artificiale, effettuare inferenze e svolgere calcoli accelerati tramite GPU.
L’incremento effettivo può comunque variare in funzione del carico di lavoro e delle caratteristiche del software utilizzato.
NVIDIA RTX 4090: le prestazioni FP16 e BF16 possono raddoppiare
Il secondo progetto riguarda invece le schede GeForce RTX 40 basate sull’architettura Ada Lovelace. In questo caso, la modifica punta ad aumentare il throughput delle operazioni Tensor FP16 e BF16 con accumulo FP32, una combinazione particolarmente importante per molti carichi di lavoro legati alle reti neurali.
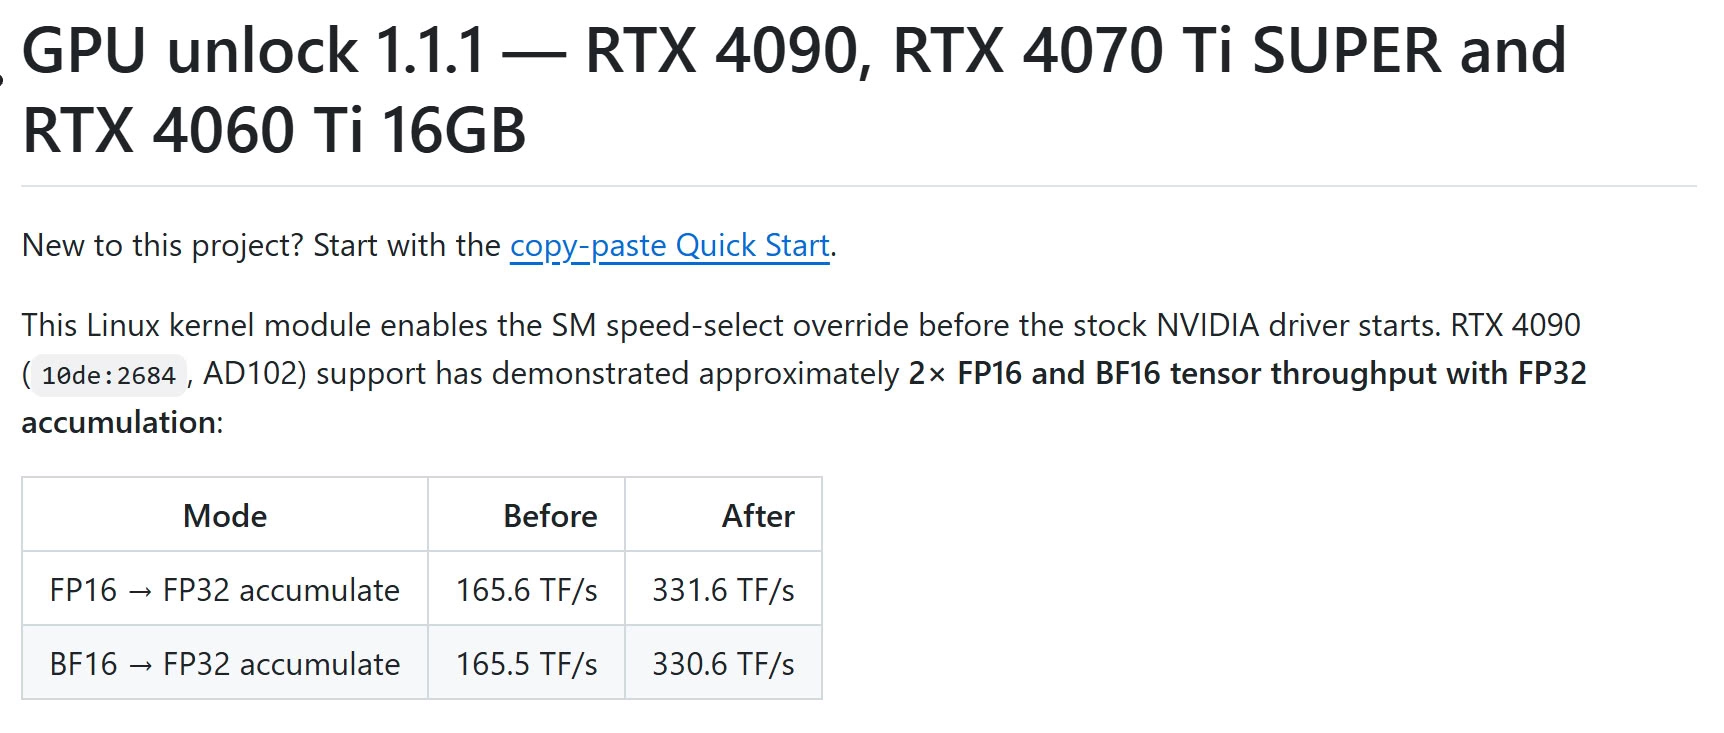
I risultati riportati per la GeForce RTX 4090 mostrano un incremento notevole. Durante un test dedicato al calcolo Tensor FP16 con accumulo delle matrici, la GPU avrebbe raggiunto una prestazione di 165,6 TFLOPS nella configurazione standard. Dopo lo sblocco, il risultato sarebbe salito a 331,6 TFLOPS.
| Test sulla GeForce RTX 4090 | Prestazioni |
|---|---|
| Configurazione standard | 165,6 TFLOPS |
| Dopo la modifica | 331,6 TFLOPS |
| Incremento | Circa 100,2% |
Il risultato corrisponde a un aumento di circa il 100%, con prestazioni che arrivano praticamente al doppio rispetto alla configurazione originale.
Valori di questo tipo avvicinano la capacità di calcolo rilevata a quella associata a prodotti professionali di fascia alta, come la NVIDIA RTX 6000 Ada Generation, almeno per le specifiche operazioni matematiche considerate.
È importante precisare che un raddoppio delle prestazioni in uno specifico benchmark non equivale a un raddoppio delle prestazioni complessive della scheda video.
Nei videogiochi e nelle applicazioni che non sfruttano le istruzioni interessate dalla modifica, i benefici potrebbero essere limitati o assenti. Lo sblocco per l’architettura Ada Lovelace risulta indicato per le GPU AD102, AD103 e AD106.
Più potenza per i modelli AI locali e gli LLM
Il principale vantaggio di queste modifiche riguarda l’esecuzione locale dei modelli di intelligenza artificiale. Le GPU vengono utilizzate sempre più spesso per eseguire chatbot, modelli linguistici e strumenti generativi direttamente sul proprio computer, senza dipendere necessariamente da servizi cloud.
In questi scenari, la velocità delle operazioni matematiche sulle matrici può influenzare sensibilmente le prestazioni. Un aumento del throughput computazionale può infatti migliorare due fasi importanti dell’elaborazione degli LLM:
- Prefill: la fase in cui il modello elabora il prompt iniziale e prepara le informazioni necessarie per generare la risposta.
- Decode: la fase in cui il modello produce progressivamente i token che compongono il testo generato.
Una GPU capace di eseguire più rapidamente le operazioni supportate può quindi offrire una maggiore velocità di elaborazione, riducendo i tempi di attesa durante l’utilizzo di modelli locali.
Il vantaggio concreto dipende però da diversi fattori, tra cui la quantità di memoria video disponibile, la dimensione del modello, la precisione numerica utilizzata, il software di inferenza e l’eventuale presenza di altri colli di bottiglia.
Per questo motivo, i risultati ottenuti nei benchmark matematici non possono essere automaticamente trasferiti a ogni modello linguistico o applicazione di intelligenza artificiale.
Driver NVIDIA standard e consumi invariati
Uno degli aspetti più interessanti dei due progetti è il modo in cui vengono applicate le modifiche. Secondo le informazioni disponibili, entrambi gli interventi superano i controlli dei driver NVIDIA e aggirano alcune limitazioni legate al ripristino della funzione PCIe Function Level Reset (FLR), consentendo di utilizzare i normali driver dell’azienda.
Anche i benchmark CUDA possono essere eseguiti normalmente dopo lo sblocco. Un altro elemento rilevante riguarda i consumi energetici. Nei test descritti, la potenza nominale della scheda sarebbe rimasta invariata prima e dopo la modifica.
Per le GPU GA102 e AD102 viene indicato un limite di potenza della scheda pari a 450 watt in entrambe le configurazioni. Il miglioramento, quindi, non deriverebbe da un semplice aumento del consumo energetico o da un overclock tradizionale, ma dalla possibilità di sfruttare più efficacemente determinate capacità di calcolo della GPU.
Questo aspetto rende le modifiche particolarmente interessanti per chi utilizza schede video consumer per carichi di lavoro professionali e di ricerca.
Attenzione: le modifiche possono invalidare la garanzia
Nonostante i risultati promettenti, questi interventi non sono privi di controindicazioni. Le modifiche non sono ufficialmente supportate da NVIDIA e possono richiedere procedure specifiche per essere applicate correttamente. Inoltre, secondo le indicazioni riportate, devono essere attivate durante l’avvio del sistema, prima che i driver NVIDIA associno la scheda video al kernel.
Un’installazione non corretta o un’incompatibilità con il sistema utilizzato potrebbero provocare malfunzionamenti. Trattandosi di interventi che modificano il comportamento della GPU al di fuori delle configurazioni ufficialmente previste, è inoltre necessario considerare i possibili rischi per la stabilità del sistema.
La garanzia rappresenta un ulteriore elemento da valutare: intervenire sulla scheda video in questo modo può comportarne la perdita, secondo le condizioni applicabili al prodotto e al tipo di modifica effettuata.
Per la maggior parte degli utenti, quindi, non si tratta necessariamente di una soluzione consigliabile. I potenziali benefici sono più rilevanti per chi conosce le procedure di modifica e utilizza la GPU principalmente per calcoli scientifici, sviluppo e inferenza AI.
NVIDIA limita le GPU GeForce rispetto ai modelli professionali?
I risultati riaccendono il dibattito sulle differenze tra le schede video consumer e quelle professionali. Le GeForce RTX e le GPU della famiglia NVIDIA RTX professionale possono condividere lo stesso chip fisico, ma questo non significa che offrano necessariamente le stesse prestazioni in ogni applicazione.
Le differenze possono dipendere da configurazioni hardware, firmware, driver, funzionalità abilitate e caratteristiche specifiche dei prodotti. Anche la memoria disponibile e il supporto software possono incidere significativamente sulle prestazioni dei carichi di lavoro professionali.
I progetti di sblocco suggeriscono che alcune GPU GeForce potrebbero offrire maggiori capacità di calcolo in determinate operazioni rispetto a quelle accessibili nella configurazione standard. Tuttavia, i risultati riportati non dimostrano che tutte le differenze tra i prodotti consumer e professionali siano riconducibili a limitazioni artificiali.
Le schede professionali continuano infatti a distinguersi anche per altri aspetti, come la quantità di memoria, il supporto software e le funzionalità specifiche per gli ambienti di lavoro professionali.
Conclusioni: le GeForce RTX nascondono un potenziale per l’AI?
I due progetti dimostrano quanto le prestazioni delle GPU possano dipendere non soltanto dall’hardware, ma anche dal modo in cui firmware e software consentono di sfruttarne le capacità.
Le modifiche per NVIDIA GeForce RTX 30 e RTX 40 hanno mostrato incrementi significativi in specifici carichi di lavoro matematici, con risultati particolarmente rilevanti sulla RTX 3090 Ti e sulla RTX 4090.
Per chi utilizza modelli linguistici locali e applicazioni di intelligenza artificiale, la possibilità di aumentare il throughput computazionale senza incrementare il consumo nominale rappresenta un aspetto interessante.
Restano tuttavia da considerare la compatibilità, la stabilità e i rischi associati agli interventi non ufficiali. Inoltre, i risultati dei benchmark dovranno essere valutati caso per caso per capire quanto si traducano in miglioramenti reali nelle applicazioni quotidiane.
La questione centrale è quindi capire quanto potenziale aggiuntivo possa essere sfruttato dalle GPU GeForce e quali compromessi siano necessari per accedervi. Per gli appassionati di AI e calcolo accelerato, si tratta di sviluppi da seguire con attenzione, senza confondere i risultati ottenuti in test specifici con un aumento generalizzato delle prestazioni.
HW Legend Staff